Syntidata
Технология генерации синтетических датасетов
Наш конвейер превращает описание задачи в готовый датасет с разметкой: от библиотеки 3D-моделей до экспорта в COCO или YOLO. Каждый этап настраивается под клиента и масштабируется на сотни тысяч изображений.
Общая схема конвейера
Технология Syntidata — это последовательность этапов, каждый из которых делает одну понятную вещь и передаёт результат следующему. Такая модульность позволяет менять отдельные звенья, не перестраивая всё остальное: заменить набор фонов, добавить новый класс объектов, переключить формат разметки.
Сквозной путь выглядит так:
- Библиотека 3D-моделей объектов и окружения.
- Сборка сцен по заданным правилам.
- Рандомизация освещения, материалов, камер и фонов.
- Рендер изображений.
- Автоматическая разметка: маски, рамки, глубина, ключевые точки.
- Контроль качества.
- Экспорт в нужные форматы и передача клиенту.
Главное отличие от ручного сбора в том, что разметка появляется одновременно с изображением. Мы не обводим готовые кадры: мы создаём кадры, в которых положение каждого объекта известно точно. Общую идею мы разбирали в статье Что такое синтетические данные и почему о них заговорили все, здесь же подробно о том, как это работает на практике.
Этап 1. Библиотека 3D-моделей
Любой датасет начинается с того, что нужно показать модели. Для этого мы формируем библиотеку 3D-моделей: целевых объектов, объектов-помех и элементов окружения.
Откуда берутся модели
- Чертежи и CAD-файлы заказчика. Если у вас есть конструкторская документация, мы конвертируем её в модели, пригодные для рендера: упрощаем геометрию, назначаем материалы.
- Моделирование с нуля. По фотографиям, эскизам и описаниям наши 3D-художники строят модели вручную. Это основной путь для упаковки, мебели, одежды, оборудования.
- Фотограмметрия. Для некоторых реальных предметов быстрее получить модель по набору снимков. Подробнее об этом методе в статье Фотограмметрия: как получить 3D-модель реального предмета.
- Несуществующие объекты. Прототипы, новые варианты изделий, гипотетические дефекты. Для таких объектов реальных фотографий не существует в принципе, и именно здесь синтетика не имеет альтернатив.
Что важно в модели
Хорошая модель для датасета — это не только форма. Критичны масштаб (объект должен иметь реальные размеры, иначе перспектива выйдет неверной), материалы (шероховатость, металличность, прозрачность), а также детализация, достаточная для крупных планов, но не избыточная для массового рендера. Мы оптимизируем геометрию так, чтобы сохранить внешний вид и не тратить вычислительные ресурсы впустую.
Для вариативности каждый класс объектов часто представлен несколькими моделями и параметрическими отклонениями: разные оттенки, степень износа, царапины, загрязнения. Модель, видевшая только идеальную банку, не узнает помятую.
Этап 2. Сборка сцен
Из библиотеки моделей собираются сцены. Сцена — это набор объектов, их расположение и окружение: стол, конвейерная лента, полка магазина, склад, поле.
Мы используем процедурную сборку: правила описывают, что и где может находиться, а конкретная компоновка выбирается случайно. Правила бывают такими:
- количество объектов в кадре от одного до нескольких десятков;
- допустимая плотность размещения и перекрытия;
- физически правдоподобное расположение: предметы стоят на поверхностях, лежат, падают под действием гравитации, а не висят в воздухе;
- доля объектов-помех и отвлекающих элементов;
- специальные композиции: штабели, ряды на полке, россыпь деталей.
Физическая симуляция помогает получить естественные позы: детали, высыпанные в ящик, ложатся так, как лягут в реальности. О подходе подробнее рассказано в статье Процедурная генерация сцен для датасетов.
Для каждой сцены сохраняется полное описание. Это важно для воспроизводимости: любой кадр можно пересобрать, изменив один параметр.
Этап 3. Рандомизация
Рандомизация — самая важная часть технологии. Именно она определяет, обобщится ли модель на реальный мир. Идея в том, чтобы варьировать всё, что может отличаться в жизни, так сильно, чтобы реальность оказалась «ещё одним вариантом» из обученного диапазона.
Освещение
Мы меняем тип, количество, положение, цвет и интенсивность источников света, а также используем HDRI-карты окружения для реалистичных отражений. Тени, блики, пересвеченные и недоосвещённые зоны получаются физически корректно. См. статью Освещение в рендере: HDRI, источники и тени.
Материалы
Цвет, глянцевость, текстура поверхности, степень износа. Для металла, пластика, стекла, ткани, дерева используются физически обоснованные PBR-материалы. Благодаря этому поверхность реагирует на свет так же, как в реальности.
Камеры
Положение, угол наклона, фокусное расстояние, глубина резкости, размытие движения, шум матрицы, виньетирование, искажения объектива. Мы подбираем параметры под вашу реальную камеру, если характеристики известны: тогда синтетика выглядит так, как будто её сняло ваше оборудование.
Фоны и окружение
Однородные и сложные фоны, реальные текстуры, случайные объекты вокруг. Часть фонов может быть взята из ваших реальных кадров, чтобы синтетические объекты оказывались в узнаваемой обстановке.
Баланс случайности
Полностью случайный набор параметров расточителен: часть кадров получится нереалистичной. Поэтому мы задаём диапазоны по результатам изучения вашей задачи и корректируем их после пробных запусков. Принципы рассмотрены в статье Доменная рандомизация на практике.
Этап 4. Рендер
Рендер — самый ресурсоёмкий этап. Мы используем физически корректный трассировщик лучей, который моделирует распространение света: отражения, преломления, мягкие тени, рассеивание. Для задач, где фотореализм не критичен, можно применять быстрые режимы и получать кадры в разы быстрее.
Параллельная обработка идёт на кластере: сцены раскладываются по узлам, результаты собираются в общее хранилище. Для типового кадра разрешения порядка Full HD время рендера варьируется от долей секунды до нескольких минут в зависимости от сложности сцены и качества. Поэтому на больших датасетах мы заранее планируем нагрузку и контролируем сроки.
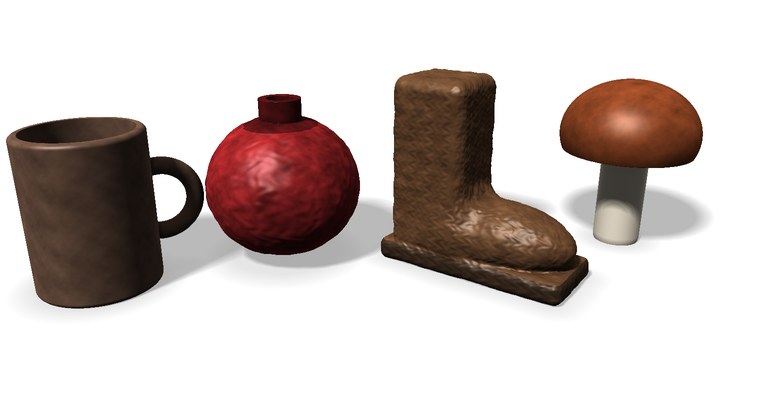
Из одного рендера мы можем получать сразу несколько представлений: обычное цветное изображение, карту глубины, карту нормалей, маски по классам и по отдельным экземплярам. Всё это строится из одной и той же сцены и поэтому идеально согласовано друг с другом.
Этап 5. Автоматическая разметка
Здесь проявляется главное преимущество. Поскольку мы знаем геометрию каждого объекта, разметка вычисляется напрямую, без участия человека.
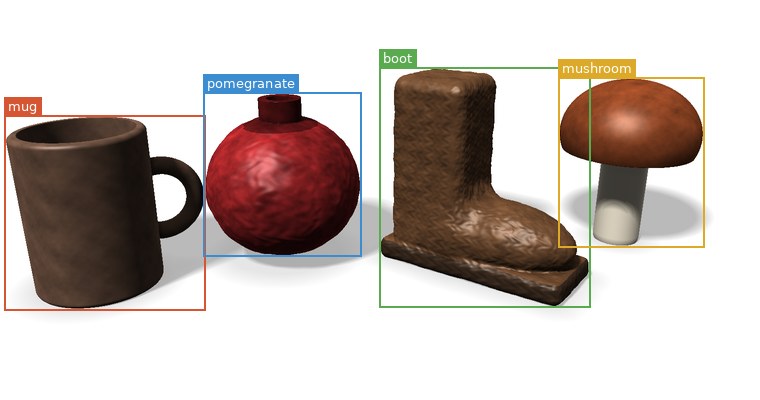
- Баундинг-боксы. Ограничивающие рамки строятся по проекции объекта на изображение. Можно получить рамку по видимой части или по полному объекту, включая перекрытую часть.
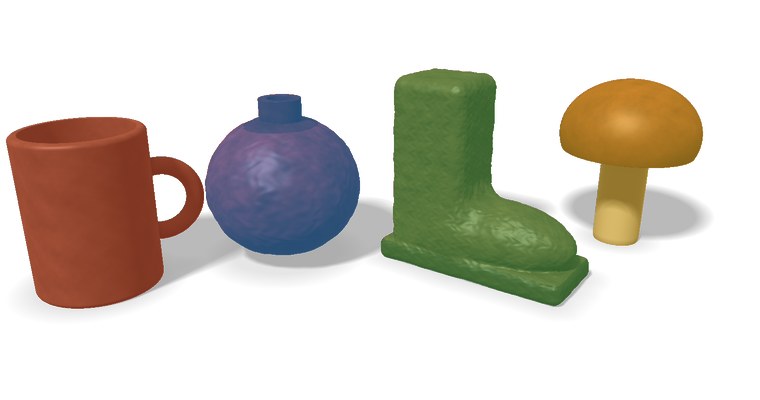
- Маски сегментации. Попиксельные маски классов и экземпляров. Каждое растение, каждая деталь, каждая банка — отдельная маска.
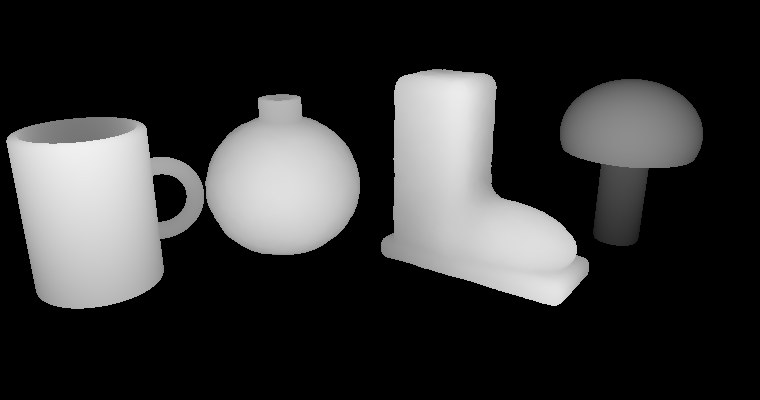
- Карты глубины. Расстояние от камеры до каждой точки сцены в метрах.
- Ключевые точки. Суставы, углы деталей, точки крепления. Положения задаются на 3D-модели один раз и затем проецируются на любые ракурсы.
- Дополнительные атрибуты. Степень перекрытия, усечение рамкой кадра, ориентация, идентификатор модели.
Точность такой разметки ограничена только разрешением изображения. Нет дрожащих рамок, пропущенных мелких объектов и разных трактовок одного и того же. Подробнее о типах: Виды разметки изображений: обзор. Все это относится к направлению Разметка: маски и баундинг-боксы.
Этап 6. Контроль качества
Автоматическая разметка не отменяет проверок. Мы контролируем сам датасет на нескольких уровнях.
- Технические проверки. Нет пустых кадров, рамки лежат в пределах изображения, маски не пересекаются некорректно, размеры объектов в допустимом диапазоне.
- Статистика. Распределение классов, размеров объектов, положений в кадре, яркости и контраста. Если все объекты оказались в центре или все кадры слишком тёмные, это видно по распределениям.
- Визуальная выборка. Специалист просматривает случайные кадры и ищет артефакты: проваливающиеся сквозь поверхность предметы, неправдоподобные блики, нечитаемые элементы.
- Проверочное обучение. Мы обучаем небольшую модель на части данных и оцениваем её на реальных кадрах, если они предоставлены. Это самый честный тест: он показывает, работает ли датасет, а не только красив ли он.
Метрики качества и порядок проверки описаны в статье Как проверить качество синтетического датасета.
Этап 7. Экспорт и передача
Итоговый датасет выгружается в формате, который удобен вашей команде: COCO, YOLO, Pascal VOC, собственные схемы JSON или CSV. Изображения передаются в выбранном формате и разрешении, разметка сопровождается описанием структуры и списком классов. Дополнительно мы можем отдать файлы описания сцен, чтобы вы могли оценивать вклад отдельных факторов.
Датасет делится на обучающую, валидационную и тестовую части с учётом того, чтобы похожие сцены не попадали сразу в несколько выборок. Иначе метрики будут завышены. Форматы разбирает статья Форматы аннотаций: COCO, YOLO, Pascal VOC и другие.
Сравнение с ручным сбором
| Параметр | Ручной сбор и разметка | Синтетический датасет |
|---|---|---|
| Старт проекта | Нужны объекты, съёмка, площадка | Нужны описание и 3D-модели |
| Разметка | Вручную, возможны ошибки и расхождения | Автоматически, без ошибок человека |
| Редкие случаи | Приходится ждать, пока они произойдут | Создаются по требованию |
| Несуществующие объекты | Невозможно | Возможно |
| Условия съёмки | Зависят от погоды, смены, площадки | Задаются параметрами |
| Масштабирование | Стоимость растёт почти линейно | Стоимость на кадр снижается с объёмом |
| Дополнительные слои (глубина, нормали) | Требуют специального оборудования | Получаются бесплатно |
| Правки по итогам обучения | Новая съёмка и разметка | Изменение параметров и перегенерация |
| Приватность | Люди и коммерческие тайны в кадре | Данные искусственные |
Эта таблица не означает, что реальные данные не нужны. Они служат эталоном для проверки, а во многих проектах лучший результат даёт смесь двух источников. О пропорциях смотрите в статье Смешивание синтетики и реальных данных: пропорции и стратегии.
Масштабирование на большие датасеты
Технология создавалась так, чтобы большие объёмы не требовали пропорционального роста усилий. Основные затраты приходятся на подготовку: библиотеку моделей, правила сцен, настройку рандомизации. Эти работы делаются один раз. Дальше датасет растёт за счёт вычислительных ресурсов, а они масштабируются горизонтально.
На практике это выглядит так:
- первые несколько сотен кадров нужны, чтобы отладить сцены и диапазоны;
- затем объём наращивается до десятков тысяч, и по метрикам видно, где модель всё ещё ошибается;
- при необходимости мы усиливаем проблемные сценарии и догенерируем нужные кадры, а не пересобираем всё заново;
- на объёмах от 50 000 изображений и выше стоимость одного кадра заметно ниже, чем на малых заказах, а ручной сбор в такие цифры обычно не укладывается по срокам.
Каждый датасет версионируется: можно вернуться к предыдущему состоянию, сравнить два варианта генерации, понять, какое изменение улучшило метрику. Полный список услуг по этому направлению собран на странице Синтетические датасеты.
Что дальше
Если вы хотите убедиться, что технология подойдёт вашей задаче, самый короткий путь — тестовый датасет. Он предоставляется по запросу, и на нём можно проверить качество рендера, формат разметки и поведение модели. Подробно этапы работы описаны на странице Как мы работаем.
Пример выдачи: изображение, рамки, маски и глубина